AI答新闻算不算直接给你看原文?欧盟顾问划了两道线
- 发布于
AI答新闻,算不算直接给你看原文?
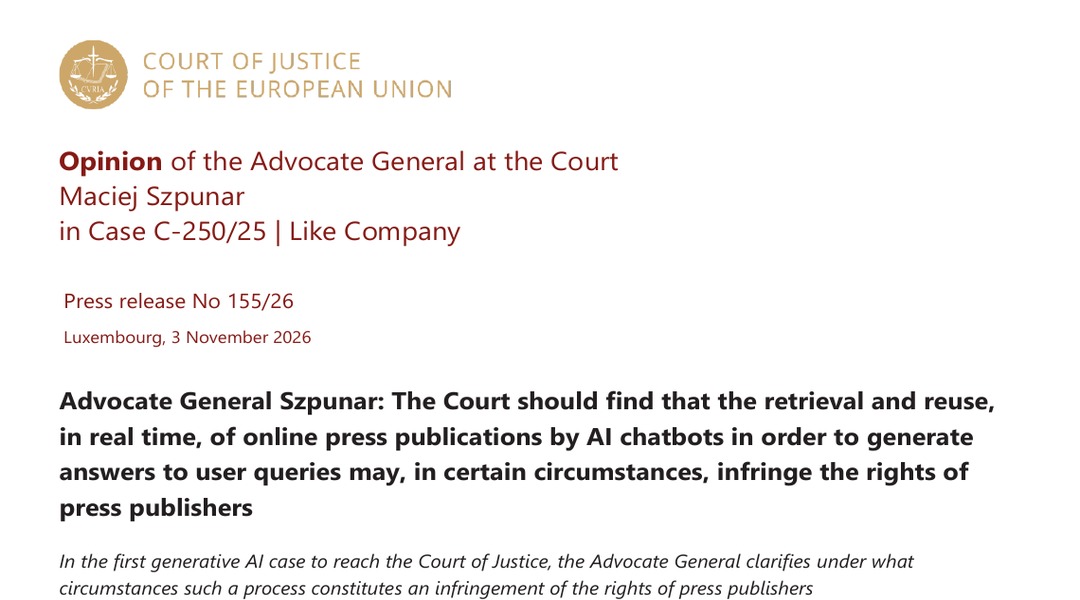
2026年11月3日,欧盟法院(CJEU)新闻稿第155/26号:第一总顾问Maciej Szpunar就案号C-250/25|Like Company发表顾问意见(Advocate General Opinion)。这是新闻稿明确写到的「抵达欧盟法院的第一起生成式AI案件」。
先把性质钉死:顾问意见不是判决。新闻稿NOTE写明——顾问独立提出法律方案,法官才开始合议,判决另择日作出。
30秒抓三点
- 争的是「现查现答」:Gemini用RAG/grounding实时从网上取新闻文章再生成回答;匈牙利门户商Like Company主张这侵害欧盟法给报刊出版者的线上邻接权(CDSM指令第15条)。
- 训练与答题拆开:顾问建议,关于「用报刊训LLM」的两个先决问题不可受理(案中无证据显示Like文章被用于训练Gemini;且训练一般不算该邻接权意义上的「online use」);顺带意见称,按文本与数据挖掘(TDM)例外,训练原则上可自由进行。真正要答的,是聊天机器人给出的答案侧。
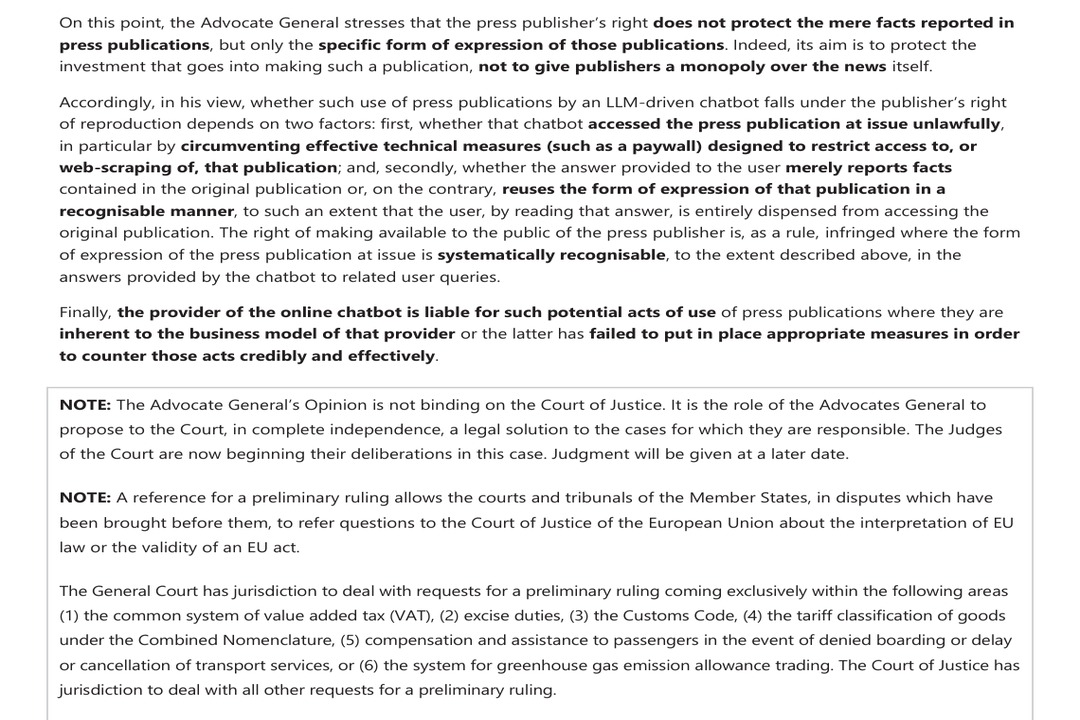
- 两道线:是否违法访问(尤其绕有效技术措施/付费墙);答案是否以可识别方式复用原作表达,以至于读者读完完全不必再打开原文。
案子在争什么
据新闻稿:Alphabet旗下Google Ireland提供的Google Gemini,靠大语言模型对话;模型侧用**Retrieval-Augmented Generation(RAG,又称grounding)**实时从万维网取信息,提高答新闻的准确度——为此经常检索(或「scrape」)在线报刊文章。
Like Company是匈牙利多家门户运营商,主张其文章受欧盟「报刊出版者」对「press publications」线上使用的邻接权保护。它诉称:Google用这些文章训练Gemini,并在2023年6月13日至2024年5月31日通过聊天机器人反复复制、向公众提供。布达佩斯地方法院中止诉讼,向欧盟法院提了四个先决问题——两个关于训练是否落入复制专有权/是否被TDM例外放开;两个关于聊天机器人答案是否落入复制权与/或向公众提供权。
顾问怎么拆:训练先放一边,盯住「答题」
顾问建议法院:
- 训练两问:不可受理。 理由写得很硬——案中没有证据证明Like的文章被用于训练Gemini;而且LLM训练不是报刊邻接权意义上的「online use」,问题属假设性。为完整起见,他另建议:用受版权及邻接权保护的材料训练LLM,原则上可依CDSM指令第4条TDM例外自由进行。
- 答题两问:才是本案该答的。 当LLM驱动的聊天机器人从出版者网站取回一篇报刊、复用以生成答案、再把答案交给用户时,在特定情形下可能侵害出版者权利。
新闻稿还强调:邻接权不保护单纯新闻事实,只保护出版物的特定表达形式——目的是保护办刊投资,不是把「新闻本身」垄断起来。
两道线怎么划
顾问把「是否落入出版者复制权」压成两个因素:
- 访问是否违法:尤其是否绕开限制访问或抓取的有效技术措施(新闻稿举例:付费墙)。
- 答案报的是事实,还是可识别地复用了原作表达:复用到什么程度?——用户读完答案,完全不必再访问原文。
向公众提供权方面:新闻稿写,当原作表达在相关用户提问的答案里系统性可识别到上述程度时,原则上构成侵害。
责任落点:在线聊天机器人提供者,若这类使用是其商业模式固有,或未采取可信且有效的应对措施,则可能承担责任。
别误读的三句话
- 不是「AI不能答新闻」。 顾问明确:保护的是表达形式与投资,不是事实;只报事实、不必打开原文的「替代阅读」才是高压区。
- 不是「训练全开绿灯已成判决」。 训练两问建议不可受理;TDM例外只是顾问「为完整起见」的附带意见,终审怎么写还看法院。
- 不是「欧盟已终审」。 新闻稿NOTE:顾问意见对法院无拘束力;法官正在合议,判决另日作出。国内读者也不应把它直接等同于「中国法已有同款专条」。
国内对照:你做AI智能体,能落成哪些动作
欧盟这条邻接权(CDSM第15条)没有在中国法里找到「同名同款的报刊出版者线上邻接权专条」。能带走的,是另一套可执行抓手:
1. 付费墙/技术措施:别当「能打开就能用」
《著作权法》第四十九条:权利人可采取技术措施;未经许可不得故意避开或破坏。第五十三条第六项把「故意避开或者破坏技术措施」列入可行政/民事乃至刑事责任的情形。顾问新闻稿里的「绕付费墙」,落到国内合同与产品里,就是:爬取策略不得设计成绕开有效访问控制;采购新闻/资讯API时,把「是否允许机器抓取、是否允许RAG grounding」写进授权范围。
2. 摘要与原文表达:划清「事实」和「可识别复用」
《著作权法》第十条第十二项:信息网络传播权——以有线或无线方式向公众提供,使公众可在其选定的时间、地点获得作品。输出侧若把他人报道的篇章结构、独特表述、独家引语段落整段可识别地吐给用户,风险不只在「是不是新闻」,而在是否实质提供了原作表达。产品动作:默认短摘要+出处链接;长引用设配额;对「读完不必点原文」的回答做抽样质检。
3. 训练数据:合法来源+知识产权留痕
《生成式人工智能服务管理暂行办法》第四条第三项要求尊重知识产权;第七条要求预训练/优化训练使用合法来源的数据与基础模型,涉及知识产权的不得侵害他人依法享有的知识产权。最高法《关于依法审理涉人工智能纠纷案件的意见》(2026年9月7日起施行)第三条(十二)写明:生成内容侵害著作权时,应综合服务类型、训练数据来源、参与度、必要措施与获利等认定开发者/提供者/使用者责任;开发者主张不侵权的,可被责令说明训练数据来源、训练过程记录、模型运行模式等。动作:训练语料台账(来源、许可类型、排除清单);出版/通讯社内容单独签授权,不要和「网页能打开」混为一谈。
4. 输出侧引用与分账:写进合同,别等纠纷再补
同一意见第三条(十六)强调合法获取数据并享有相应数据权益的应予保护。对做AI智能体/RAG新闻助手的团队:上游内容许可写清训练用/检索用/展示用三层;下游对用户输出写清引用格式与是否允许「全文级」回答;涉及转授权或广告分成的,把授权范围与分账写进合同附件,而不是只靠系统提示词。
可带走自查四问:
- 这条新闻源,有没有对付费墙/robots/API的书面授权?
- 模型回答是否让用户完全不必打开原文?
- 训练语料与RAG检索索引,来源和许可能不能当场拿出台账?
- 合同有没有把「训练/检索/展示」和分账拆开写?
欧盟顾问今天划的,是「现查现答」何时可能踩出版者邻接权;对中国读者更可执行的,是把授权、技术措施、表达边界、训练与输出分账落进产品和合同。终审怎么判,仍看CJEU后续判决。
据欧盟法院新闻稿 No 155/26(2026-11-03)及CURIA案号页;国内条文据现行《著作权法》《生成式人工智能服务管理暂行办法》及最高人民法院《关于依法审理涉人工智能纠纷案件的意见》。属普法/安全提示分享,不构成法律意见。
来源
欧盟法院新闻稿 No 155/26|Opinion of AG Szpunar in Case C-250/25 Like Company(2026-11-03)https://curia.europa.eu/site/upload/docs/application/pdf/2026-11/cp260155en.pdf CURIA|Opinion: Case C-250/25 Like Company https://curia.europa.eu/site/jcms/p1_1000088866/ro/opinion-case-c-250/25-like-company Directive (EU) 2019/790(CDSM)Art.15 / Art.4(新闻稿脚注) 中华人民共和国著作权法(2020修正)第十条、第四十九条、第五十三条 https://ydzk.chineselaw.com/zxt/statuteDetail/detailPage/883ac90ff1777df450ed46594517db13 生成式人工智能服务管理暂行办法 第四条、第七条 https://ydzk.chineselaw.com/zxt/statuteDetail/detailPage/d628e8b5d1a7bf61c66472c41e92a053 最高人民法院关于依法审理涉人工智能纠纷案件的意见 第三条 https://ydzk.chineselaw.com/zxt/statuteDetail/detailPage/f2a892644caebbf997defcda26ffe713
本站文章仅供学习交流,不构成法律意见或执业建议。