怎么证明对面没给你换便宜模型?验模型身份开源了
- 发布于
怎么证明对面没给你换便宜模型?
你付的是旗舰价,屏幕上写着某个大模型的名字——可你怎么知道,这一句答复真是那套权重算出来的,而不是被路由服务悄悄换成更便宜的模型,甚至被攻击者改过 token 流?
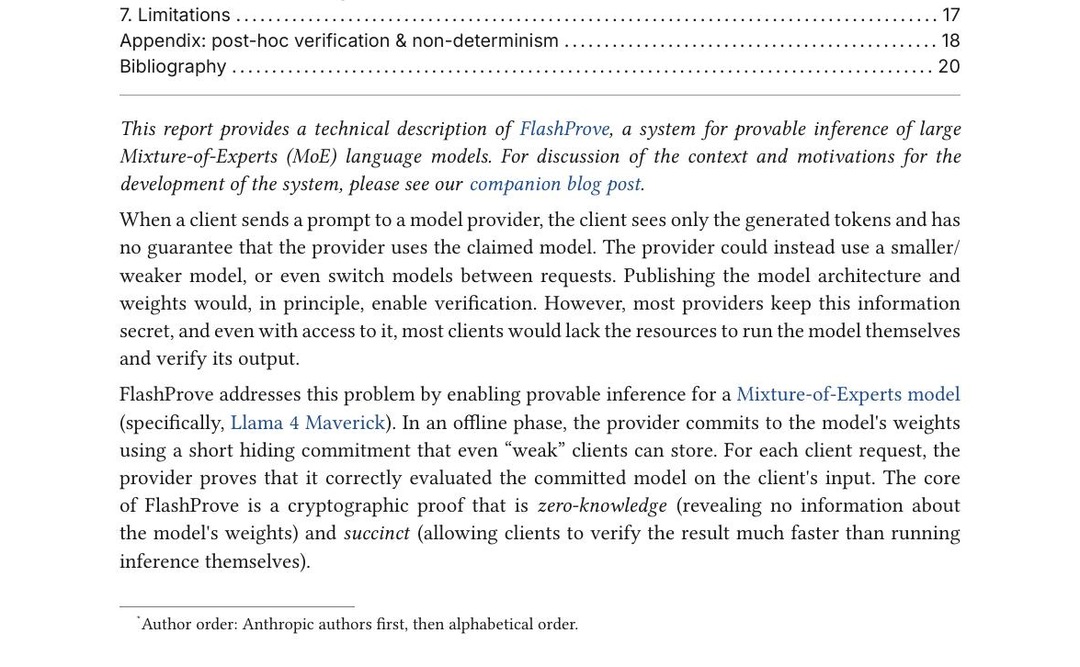
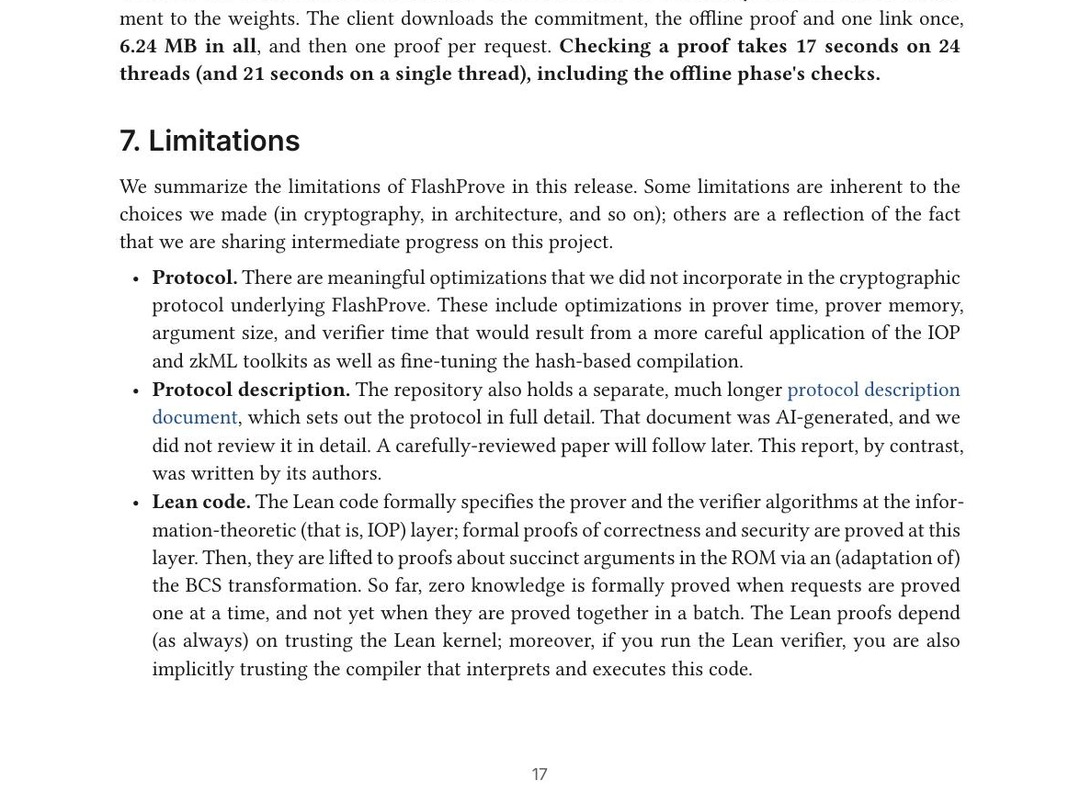
2026年11月2日,Anthropic 研究团队发文 Progress on provable inference for large language models,开源原型 FlashProve(Apache 2.0)。核心想法并不玄:提供方先对模型权重做一枚「指纹/承诺」(commitment),权重本身不泄露;之后每条(或抽检的)答复附上一份可验证证明。任何人只要拿到承诺、提示和答复,用普通 CPU 就能核对——这句话确实由承诺的那套权重算出来。
30秒抓三点
- 验的是「哪套权重」:不是内容水印,也不是「看起来像不像旗舰」;密码学证明绑定到已公开承诺的那一版权重。
- 演示数字:在 Llama 4 Maverick(约 400B MoE、4-bit)上,单张 H100 约 110 tok/s 出证,约 19 MB/1024 token 请求;官方写明这是研究原型,尚未部署到自家 Claude 量产。
- TechCrunch 11月3日跟进:把场景说得很直白——防的是「偷偷换便宜模型省成本」,或反过来「用更贵模型刷评测」。
它到底在证明什么
据 Anthropic 博文与配套技术报告:今天用户几乎没法从输出本身判断「对面是不是声称的那台模型」。日常闲聊也许无所谓;但独立评测方要确认测的就是对外服务的那一版、经第三方中转/聚合 API 采购的客户要确认付的钱对应声称的模型、以及防篡改 token 流时,光靠「读起来质量还可以」不够。
FlashProve 走的是软件侧密码学路线(zkSNARK),分两阶段:
- 离线:提供方公布对权重的短承诺(指纹),钉死「这一版」同时隐藏权重内容。
- 在线:对提示与输出给出证明文件——「被承诺的那套模型,跑这个提示,就是这些输出 token」。
证明要满足:诚实则过(完备性);假陈述几乎造不出有效证明(可靠性);证明本身不泄露权重(零知识);体积小、CPU 可验(简洁性)。官方同时强调:隐藏的是权重,不是模型架构;当前演示面向 MoE 结构,上下文约 1024 token;证明的是整数化权重下的贪心解码,与浮点/采样解码可能有偏差。
开源了什么,别当成「Claude 已上线验身」
官方一并放出:博文、技术报告、协议说明、可执行代码(含 C++ 快速验证器与 Lean 侧验证器)、以及顶层安全性质的 Lean 形式化。代码与文档以 Apache 2.0 开源,GitHub 仓库为 anthropics/FlashProve。
TechCrunch 同日跟进写明:研究仍在继续,没有部署到 Anthropic 或其他实验室量产的计划表述;博文自己也说这是 intermediate progress,欢迎外人拿去改、拿去快。
所以成稿口径先钉死三句:
- 研究原型 ≠ Claude 已对用户默认附证明。
- 能验的是「是否匹配已承诺权重」,不是自动识别世界上每一个未承诺的黑盒模型。
- 开源演示用的是 Llama 4 Maverick 的公开 4-bit 权重(按 Meta 许可自行下载),不是把 Claude 权重公开。
国内轻对照:合同验收、虚假宣传、标识与取证
中国目前没有一部名叫「可证明推理」的专法。能直接带走的,是另一套已经存在的抓手——尤其当你买的是「旗舰模型 API」、或经中转/聚合层调用时:
1. 合同标的与验收:把「模型身份」写进可抽检条款
采购/SAAS 合同里,「模型名称」往往只是产品页文案。可对照《民法典》合同编关于标的、质量与验收的约定思路:把对外承诺的模型标识、版本/snapshot、是否允许降级路由、抽检频率、证明或日志留存期限写进附件。FlashProve 这类工具若未来被提供方支持,合同可要求「承诺 ID+抽检证明」;即便对方尚未支持密码学证明,至少可要求不可单方静默降级、降级须通知与差价处理,以及抽检对话的完整请求/响应留痕。
2. 广告与公示:别只挂旗舰名
《广告法》对虚假宣传的规制,盯的是引人误解的内容。对外宣传「旗舰模型/某版本」而实际大量路由到更便宜模型,若足以影响交易决策,风险不在「有没有 zkSNARK」,而在宣传与交付是否一致。产品页、报价单、中转控制台展示的模型名,应与真实路由策略一致;「智能路由省钱」可以卖,但要说清楚默认落在哪一档。
3. 深度合成与生成内容标识:另一条线,别混成一条
国家网信办等部门关于深度合成、生成式人工智能服务的标识要求,主要解决「这是不是 AI 生成/合成」的披露,不等于「是哪一套权重」。水印、显式标识与「可证明推理」互补:前者标内容属性,后者(若落地)标模型身份。做 AI智能体产品时,两边都要有人负责,不要用「已经加了 AI 标识」代替「客户买的模型档位是否属实」。
4. 中转/聚合 API:挂羊头的举证难题
经第三方网关转发时,终端用户往往只能看见网关填写的模型字段。采购方可要求:上游提供方名称与模型 ID 原样透传、禁止改写;抽检样本可回源核对;争议时以合同约定的日志与(若有)证明文件为准。监管与评测场景里,Anthropic 文中也谈到 pacing/审批模型等用途——对国内读者更可执行的,仍是验收条款+抽检台账,而不是等待某条「验模型专法」。
可带走自查四问:
- 合同有没有写清「不得静默降级/替换模型」?
- 宣传页上的模型名,和网关真实路由是否一致?
- 抽检样本能否追溯到具体模型版本与时间戳?
- 中转层是否允许改写上游模型字段?
别误读的三句话
- 不是「以后每次聊天都会自动弹出证明」。 当前是研究原型与开源演示;在线证明还有延迟、成本与上下文长度等限制。
- 不是「中国已经强制 API 必须附 zk 证明」。 上文国内对照是合同、广告与标识等既有规则的映射,不是新立专法。
- 不是「有了证明就可以泄露或索要权重」。 设计目标之一恰恰是:验证不需要、也不应看到权重。
Anthropic 这次把「你付的旗舰价,对面是不是真旗舰」从口头信誉推进到可开源复现的密码学原型;对中国采购方与做 AI智能体的团队,更可执行的落地仍是:宣传一致、合同可抽检、中转不改名、标识与验货分线管理。研究原型怎么长成产品默认能力,还看后续工程与行业采用。
据 Anthropic 研究博文 Progress on provable inference(2026-11-02)、FlashProve 技术报告与 GitHub 仓库;TechCrunch 2026-11-03 报道。
LexAI律智 | 仅为普法/安全提示分享,不构成法律意见。
来源
Anthropic|Progress on provable inference for large language models(2026-11-02)https://www.anthropic.com/research/provable-inference Anthropic|FlashProve technical report https://www.anthropic.com/document/flashprove-technical-report GitHub|anthropics/FlashProve(Apache 2.0)https://github.com/anthropics/FlashProve/ TechCrunch|Anthropic is working on a system to prove AI models' identity(2026-11-03)https://techcrunch.com/2026/11/03/anthropic-is-working-on-a-system-to-prove-ai-models-identity/ X|@AnthropicAI 官方帖 https://x.com/AnthropicAI/status/2117710942826123294
本站文章仅供学习交流,不构成法律意见或执业建议。