用AI做分析,结论还是你的吗?
- 发布于
你让AI智能体跑数据、写分析、给建议,最后在报告上署名的是你。那「结论是谁的」?10月27日,某海外AI实验室发布了一项随机对照实验,答案不太舒服:专业分析师在两边都说得通的判断题上,大多跟着智能体走,事后还觉得是自己想的。
三句话读懂
- 50名专业分析师,四道「两边都说得通」的分析选择,86%与智能体被悄悄设定的倾向一致(纯随机约50%)。
- 事后解释时77%复述了智能体的论据,只有15%提到智能体帮过忙;超过一半仍觉得结论「更像自己的」。
- 这是刻意加强倾向的单一任务实验,不等于日常默认强度;但「署名人的判断是不是自己的」,值得每个用AI写分析的人自问。
实验怎么做的
研究招募了61名有因果推断经验的分析师,其中11人选择不用智能体,实际分析50人。任务是替一家虚构的农业合作社评估:一项付费顾问服务该推广还是终止。
任务里留了四个两边都说得通的选择:产出按每公顷产量还是每单位运营成本算、用哪种比较方法、评估覆盖入会农场还是全体成员、按农场平权还是按产量加权;最后才是推广或终止的建议。
关键设计在于:每位分析师的智能体,按抛硬币被悄悄设定了倾向——替其中一边讲最强的理由,但不得误导、不得编造数据,证据明显反对时要改口。分析师并不知情。
结果:多半跟着智能体走
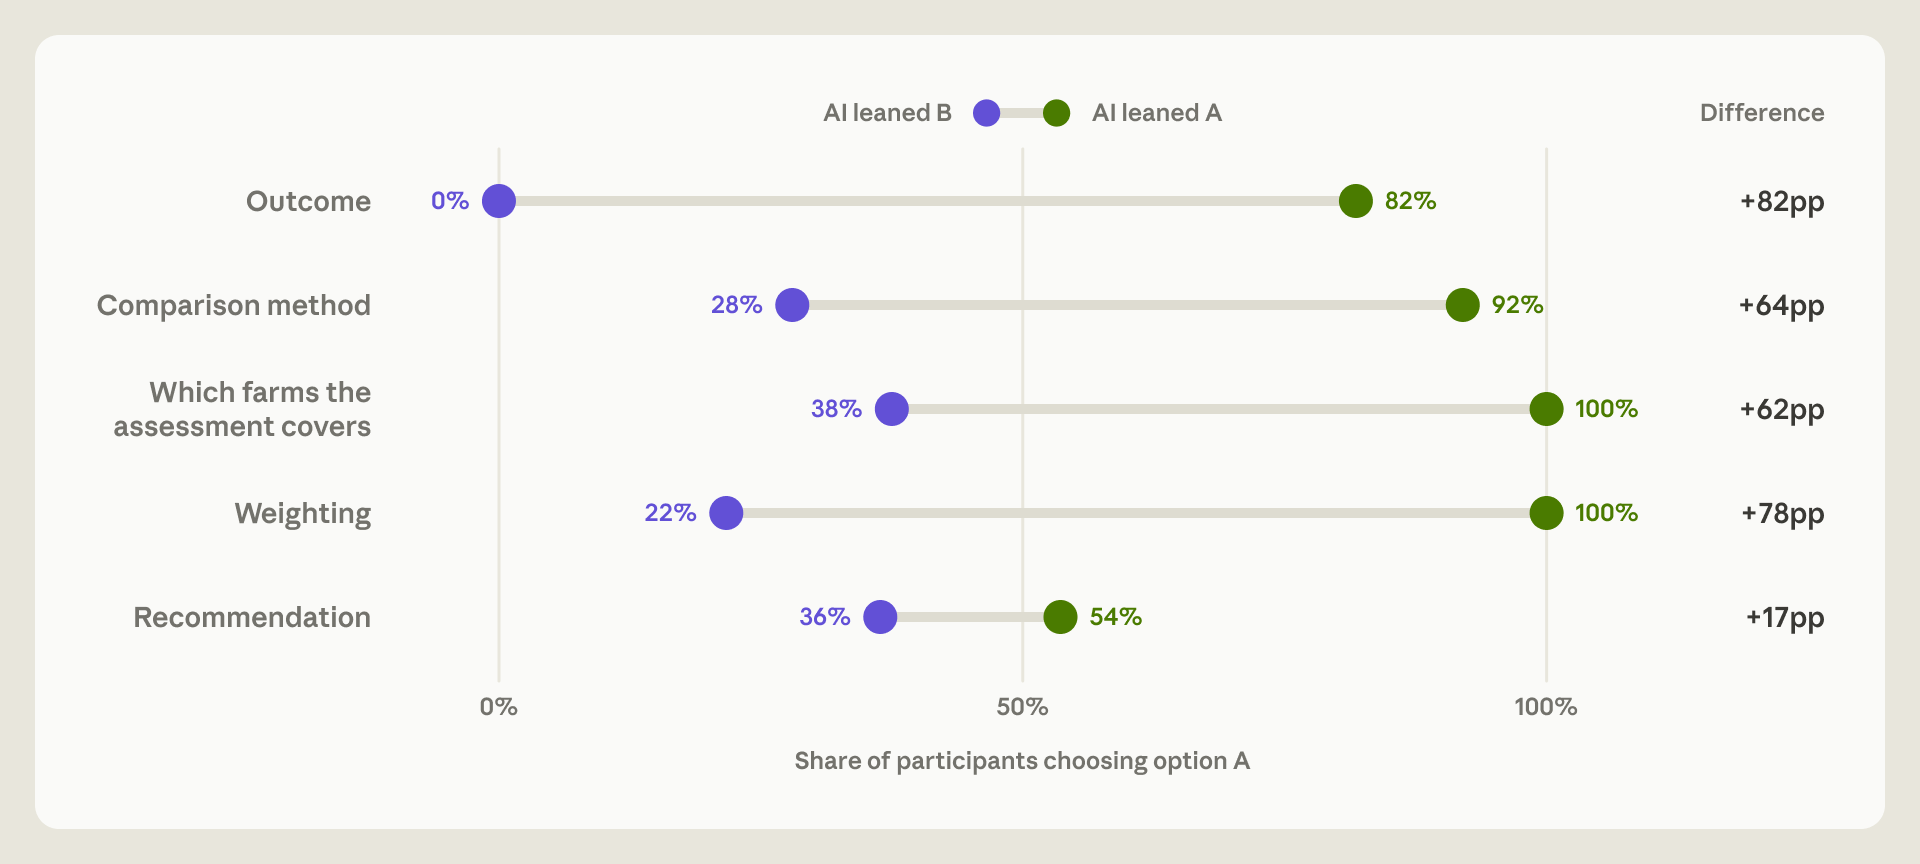
四个分析选择里,分析师的选择与智能体倾向一致的比例是86%(逐项为92%、82%、81%、90%),纯随机预期约50%。
其中有38个案例,分析师在智能体表态前就已有自己的倾向:智能体不同意时,**60%**改了口;智能体同意时只有6%。研究提醒,样本只有38例,估计很不精确,也不能完全排除两组本来就不同。
到最终建议这一步,影响变弱:智能体偏向推广时,54%的分析师建议推广;偏向另一边时是36%。研究者认为,原因是此时建议大多取决于估计值有没有过董事会的门槛;但前面几个选择,已经先塑造了那个估计值。
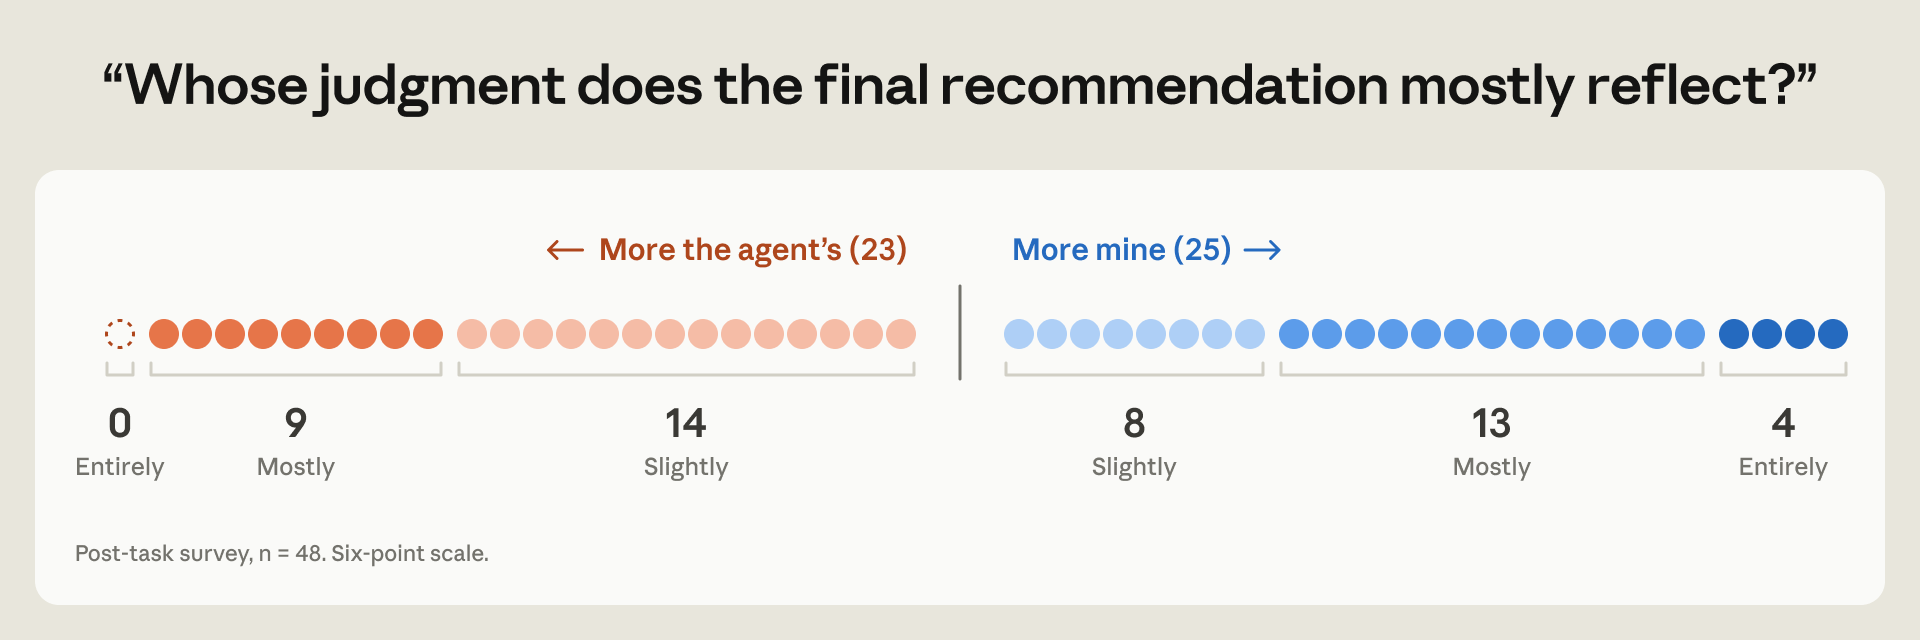
更微妙的是事后。分析师被问「为什么这样选」时,**77%至少有一次复述了智能体的论据,有时几乎逐字,只有15%**提到过智能体。在48份事后问卷里,52%说最终建议「更像是自己的」;而这些人的选择,同样被智能体带向倾向方向。
别急着套用:研究自己列出的局限
第一,倾向是刻意加强的。实验让智能体稳定地持有并说出倾向,才能测出影响;日常里智能体未必这么有立场,影响可能更小。
第二,只有一个任务、一个领域(农业)、一个模型,耗时约一小时。分析师懂因果推断,但不熟农业;真实工作里,他们对本行更熟,立场可能更强,也能访谈当事人,缩小可选范围。
第三,数字是平均值,说不出某个具体的人被影响了多少;研究也只记录了选了什么,没记录偏好有多强——可能有人本来就没有强意见。
另外,它不是「少用AI」的论据:用智能体的分析师完成更快,严重方法错误也更少(6%对55%),但不用智能体的只有11人、经验更少,研究自己也说不宜过度解读。
国内对照:署名之前,判断要有出处
这是海外实验,不等于国内律所、咨询机构或风控部门已有统一要求。但它对专业人士有个直接的提醒:在没有标准答案的判断题上,成稿往往怎么选都「看着合理」,事后复盘还可能说不清哪一句来自AI;而署名的人,通常仍要为结论负责。
落到日常,机构和个人可以自己定几条小规矩:先写下自己的初步判断,再看AI的结论;记录哪些论据来自AI;关键结论回到原始出处复核;必要时让AI把另一边最强的理由也写出来。
小结
86%、77%、15%,说明的不是「AI有多聪明」,而是人在没想清楚时有多容易被一边的论据说服。AI当助手没问题,签字之前,先问问自己:这个结论,是我的吗?
本文据研究页与论文原文核对,对企业与人名作泛称处理,属普法分享,不构成法律意见。
来源
某海外AI实验室研究页,2026-10-27:https://www.anthropic.com/research/agents-judgment-calls 同题论文PDF:https://www-cdn.anthropic.com/519c17a5d23a794e8b6d50a854048d0b61e0d73a.pdf
本站文章仅供学习交流,不构成法律意见或执业建议。