渐冻症患者靠「想」说话,首周每分钟75个词:脑子里的话谁能看?
- 发布于
渐冻症(ALS)会一点点夺走说话的能力,但很多人的思维还在。10月28日,美国脑机接口公司Neuralink在东北渐冻症联盟(NEALS)年会上公布了VOICE试验的早期数据:一名受试者植入后第一周,用意念把脑信号转成文字,达到约每分钟75个词,词错率5.8%,词表约12.5万词。公司当天在X上也发了同一组数字,并写明这是早期言语恢复数据。
这是「科幻感」很强的一条好消息。但解码靠的是脑信号,还用了语言模型——脑子里准备说出口的那串信息,一旦变成可传输、可存储的数据,就不再只是医学问题。国内七部门意见第十三条写过「防止脑隐私泄露」;《脑机接口研究伦理指引》则要求对神经数据做全流程保护。把进展和边界一起看,才完整。
先把边界说在前面
- 这是一名受试者、第一周的数据;公司未说明75词/分钟是峰值还是平均。
- 目前公开的是会议摘要与公司口径,未经同行评议的完整论文;设备仍属研究用,未获FDA批准上市。
- 下文不写「治愈」,也不写「读心」——系统解码的是试图说话时的神经信号,不是任意读取内心想法。
公布了什么
据Neuralink在X上的说明,以及Inside BCI等对同一口径的核对:
- 时间与场合:2026年10月28日,NEALS年会;报告人包括VOICE试验主要研究者、德州西南医学中心神经外科医生Nader Pouratian。
- 试验名称:VOICE(ClinicalTrials.gov:NCT07224256),早期可行性研究,目标是评估植入式脑机接口用于交流恢复的初步安全性与效果。
- 关键数字:一名ALS受试者在植入后第一周,达到约75词/分钟,词错率5.8%,词表约12.5万词。
- 解码方式:把脑信号转成文字/合成语音;公开报道与会议摘要口径都提到,解码环节使用了AI语言模型做候选重排与上下文约束。
- 试验定位:主要终点是安全性(如12个月时与器械/手术相关的不良事件比例);言语表现是次要指标,登记信息里写的是每月「正确词/分钟」的最大值。
ClinicalTrials.gov显示,VOICE于2025年10月3日在UT Southwestern启动招募,计划纳入包括ALS、脊髓损伤、脑卒中等导致严重言语障碍的成人。Neuralink在帖文末尾也写明:设备仍属研究性质,尚未获得FDA或其他监管机构批准。
自然口语大约每分钟160词上下。学术文献里,斯坦福BrainGate团队2023年在《Nature》报告过约62词/分钟(词错率约23.8%,同为约12.5万词词表、单名ALS受试者);UC Davis团队后续在家用场景里报告过更高准确率、但速度更低的长期数据。Neuralink这次公布的速度更快,但比较要谨慎:任务是提示句还是自由表达、是峰值还是平均、会后是否还能维持,公开材料都还没写清。
为什么法律号也关心
对患者和家属,这首先是交流权的事:说得出「我渴了」「我爱你」,生活就不一样。
对规则制定者,问题会多一层:植入物采到的是反映意图与言语计划的神经信号;再经云端或本地模型解码,就变成可复制的文本、音频和日志。谁有权看?能存多久?能不能拿去训练下一代模型?受试者能不能随时退出、退出后数据怎么办?
这些问题,国内已经有专门表述,不必等「读心机」真的出现才开始想。
国内对照:脑隐私、知情同意、敏感个人信息
七部门意见第十三条:防止脑隐私泄露
工业和信息化部等七部门《关于推动脑机接口产业创新发展的实施意见》(工信部联科〔2025〕164号,成文2025年7月23日)第十三条写明:建立数据治理框架,规范对用户信息的收集、存储、使用等行为,防止脑隐私泄露,提升生物数字信息安全防护能力。同条还要求持续推动伦理研究,促进技术创新与科技伦理协调发展。
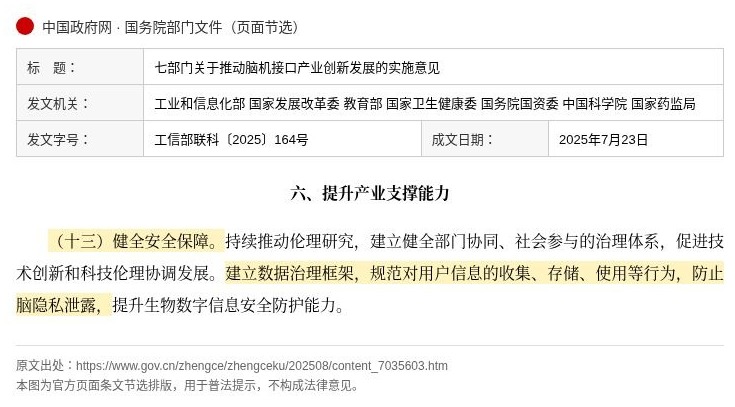
「脑隐私」四个字写进产业政策,说明官方把脑机接口数据当成需要单独点名的一类风险,而不是普通设备日志。
伦理指引:书面同意、可退出、神经数据全流程保护
国家科技伦理委员会人工智能伦理分委员会《脑机接口研究伦理指引》(科技部网站2024年2月2日发布)写得更细:
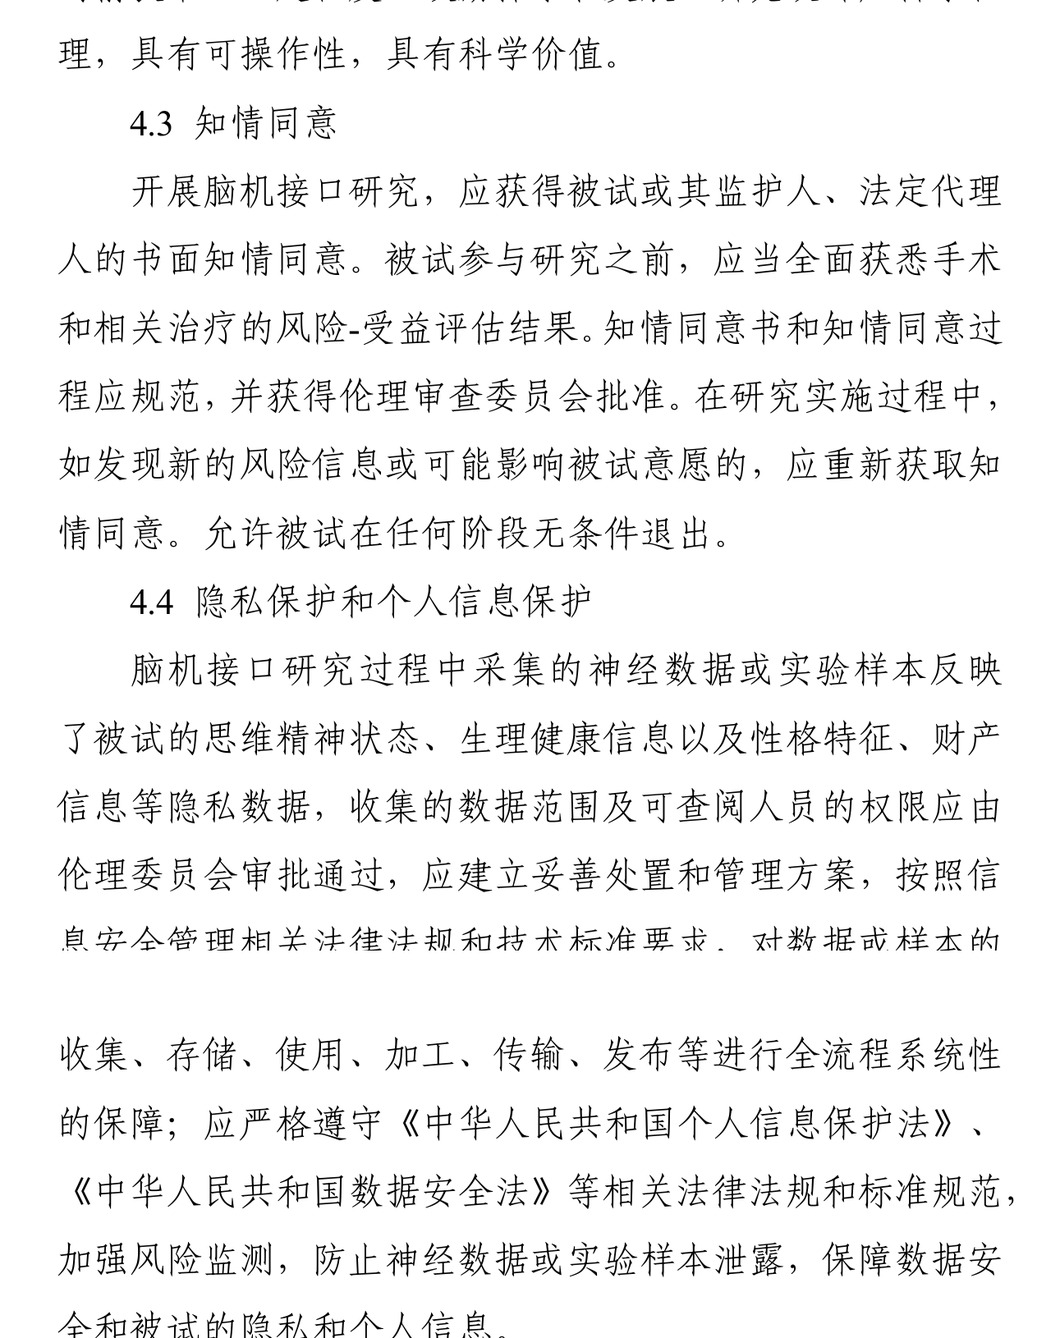
- 4.3 知情同意:应获得被试或其监护人、法定代理人的书面知情同意;全面告知风险—受益;允许被试在任何阶段无条件退出。
- 4.4 隐私保护和个人信息保护:研究中采集的神经数据反映思维精神状态、生理健康、性格特征、财产信息等隐私;收集范围与查阅权限须经伦理委员会审批;对收集、存储、使用、加工、传输、发布做全流程保障;并写明应遵守《个人信息保护法》《数据安全法》,防止神经数据或实验样本泄露。
个保法第28条:医疗健康信息是敏感个人信息
《个人信息保护法》第二十八条把医疗健康信息列为敏感个人信息。处理敏感个人信息,需要有特定目的和充分必要性,并依法取得个人的单独同意等更严格条件。脑机接口场景里的神经数据、诊疗相关记录,实务上往往要按敏感个人信息的标准去设计告知、同意、存储和对外提供。
把三条合在一起,国内对照可以收成一句话:能恢复说话是目标,能说清楚「谁在处理脑子里的数据、处理到哪一步、能不能退出」是底线。
读这条新闻时,建议记住的四点
- 进展是真的,也是早期的。 单名受试者、首周数据、会议摘要,值得关注,不宜写成「已经普及」或「已经获批」。
- 不是读心。 公开口径是言语解码——把试图说话时的神经活动转成文字或语音;不要夸张成任意读取隐私想法。
- AI在链路里。 语言模型参与解码,意味着除了植入物本身,还有算法、可能的云端处理与日志;权限、留存、再训练边界都要问清楚。
- 国内已有抓手。 「脑隐私」、神经数据全流程保护、敏感个人信息规则,已经写在意见、伦理指引和法律里;以后看试验方案和知情同意书,可以直接对照这些条款。
技术让失去声音的人重新开口,是值得高兴的事。高兴之后多问一句「脑子里的话谁能看、能看多久」,并不是唱反调,而是把好事做成可长久信任的事。
本文据Neuralink 2026年10月28日公开帖文、ClinicalTrials.gov NCT07224256登记信息、Inside BCI公开核对稿,以及中国政府网刊发的七部门意见、科技部公布的《脑机接口研究伦理指引》全文核对。属普法/安全提示分享,不构成法律意见。
AI 与法律:前沿、判例、合规。
来源
Neuralink 官方 X 帖文(2026-10-28),https://x.com/neuralink/status/2115534595009499154 Inside BCI 核对稿(2026-10-29),https://insidebci.com/news/2026-10-29-neuralink-voice-speech-75-words-per-minute-word-error-rate-als/ ClinicalTrials.gov:VOICE NCT07224256,https://clinicaltrials.gov/study/NCT07224256 中国政府网:七部门《关于推动脑机接口产业创新发展的实施意见》,https://www.gov.cn/zhengce/zhengceku/202508/content_7035603.htm 科技部:《脑机接口研究伦理指引》发布页,https://www.most.gov.cn/kjbgz/202402/t20240202_189582.html
本站文章仅供学习交流,不构成法律意见或执业建议。